
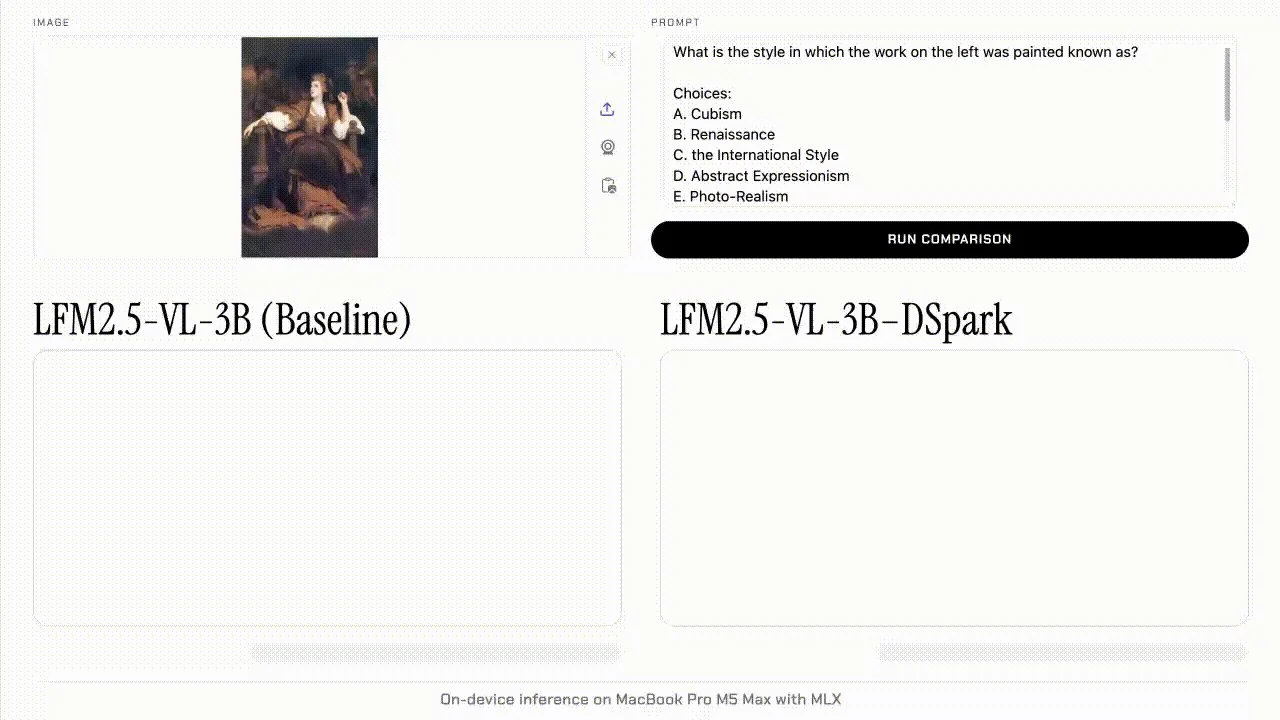
Liquid AI выпустила LFM2.5-VL-DSpark, экспериментальную драфт-модель для LFM2.5-VL-3B. Она использует спекулятивное декодирование, предлагая токены, которые проверяет основная модель, что увеличивает накладные расходы по памяти в обмен на более быстрое декодирование в тестах разработчика. Релиз поддерживает llama.cpp, MLX-VLM и SGLang.
Как работает экспериментальный драфтер
Liquid AI описывает DSpark как драфт-модель для LFM2.5-VL-3B. Она предлагает блоки токенов, которые проверяет основная модель, используя общие представления для входных изображений и текста. Это метод инференса, призванный снизить объем вычислений, необходимых для генерации ответа.
В проекте обсуждается интеграция со средами выполнения инференса, включая llama.cpp, MLX-VLM и SGLang. Добавление драфтера также влечет за собой накладные расходы по памяти, поэтому производительность необходимо рассматривать наряду с ресурсами, требуемыми для запуска обоих компонентов.
Почему важен характер нагрузки
Более быстрое декодирование токенов не обязательно означает, что весь запрос выполнится быстрее на ту же величину. Кодирование изображений и обработка входных данных могут занимать основную часть времени при некоторых нагрузках. Приведенные измерения — это тесты разработчиков на экспериментальной системе, а не гарантия для каждого устройства или приложения.
Первоисточник
В этом отчете кратко изложен материал указанного ниже источника. Аналитика приводится отдельно; заявления о продуктах и исследованиях атрибутируются их авторам.
Читать оригинал на Hugging Face